
Организация отказоустойчивого пула SOCKS5-соединений
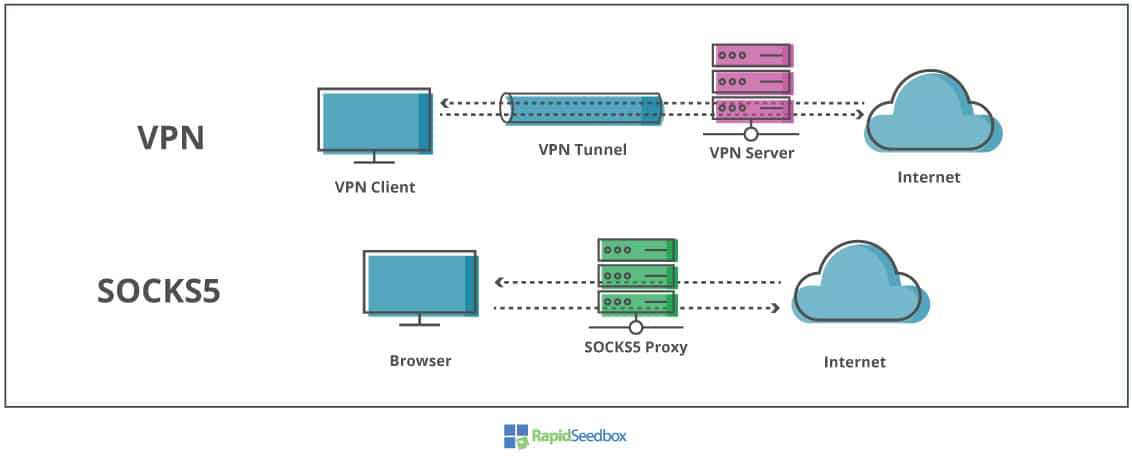
В масштабируемых системах, принимающих на себя сотни и тысячи параллельных исходящих запросов, критически важно обеспечить надёжный канал для взаимодействия с внешними сервисами. SOCKS5-прокси, благодаря своей универсальности и поддержке TCP/UDP-трафика, часто выступает основой такого канала. Однако для минимизации простоев и поддержания высокой производительности требуется выстроить отказоустойчивый пул соединений, способный автоматически адаптироваться к изменению качества каналов. Дополнительна информация доступна на сайте shopproxy.net/buy-proxy/socks5/
1. Компоненты отказоустойчивого пула
- Пул прокси-серверов. Соберите набор SOCKS5-каналов от одного или нескольких провайдеров. Желательно иметь как минимум 20–30 адресов для пилотного проекта и масштабировать до сотен при росте нагрузки. У каждого канала фиксируют метаданные: IP, порт, тип сети (дата-центр или мобильный), региональную привязку.
- Менеджер пула (Proxy Manager). Центральная служба, которая отвечает за распределение и мониторинг соединений. Через его API микросервисы или скрипты запрашивают «свободный» прокси и передают результаты его использования (время отклика, успешность).
- Клиент-адаптер. Встроенная в ваше приложение библиотека или обёртка, которая перед каждым HTTP/TCP/UDP-вызовом получает у менеджера параметры прокси, устанавливает соединение и при необходимости повторяет запросы через другие каналы.
2. Метрики качества и «период остывания»
Для принятия решений о смене прокси-канала менеджер собирает следующие метрики:
- Время отклика (Latency): среднее время установки соединения и доставки первого байта.
- Процент ошибок: доля таймаутов, отказов TCP-коннекта и разрывов сессии.
- Пропускная способность (Throughput): объём успешно переданных данных за единицу времени.
Если канал показывает более 5 % ошибок или Latency превышает заданный порог (например, 1,5 сек), он выводится из пула на «период остывания» (обычно 15–30 минут). За это время канал даёт системе возможность восстановить соединение и нагрузку.
3. Алгоритмы ротации
- Round-Robin с учётом веса. Каждый канал получает «вес» на основании метрик: чем лучше параметры, тем чаще он используется.
- Запрос-по-запросу. После каждого N-го запроса (например, 100 запросов) клиент автоматически запрашивает новый прокси.
- Таймерная смена. Менеджер принудительно меняет назначенный прокси по прошествии M минут (например, каждые 10 минут).
Комбинация этих подходов позволяет равномерно распределять нагрузку и учитывать динамику качества каналов.
4. Обработка ошибок и повторные попытки
Не все сбои можно предотвратить с помощью ротации. В клиент-адаптере внедряют стратегию повторных попыток с экспоненциальным backoff:
- При первой неудаче — повтор сразу.
- При повторной — пауза T₀ (например, 1 секунда).
- При третьей — пауза T₁ = k × T₀.
- Максимальное число попыток ограничено (обычно 3–5).
Это снижает избыточную нагрузку при временных сбоях целевого сервиса или прокси-канала.
5. Горизонтальное масштабирование и резервирование
- Автоскейлинг агентов. Оркестратор контейнеров (например, Kubernetes) автоматически разворачивает новые экземпляры микросервисов или скриптов-агентов при росте длины очереди задач.
- Географический резерв. Держите часть каналов в разных дата-центрах или облачных регионах: при аварии одному провайдеру трафик безопасно переключится на другой.
- Резервный пул. За основной группой поддерживается «холодный» пул прокси, который подключается при деградации качества основной группы.
6. Мониторинг, алертинг и отчётность
- Панель метрик. Сбор Latency, error rate и throughput каждого канала в Prometheus и визуализация в Grafana.
- Алерты. Настройка уведомлений при превышении ключевых порогов: например, если более 10 % каналов одновременно находятся в «остывании».
- Ежедневные отчёты. Автоматическая отправка сводки по качеству пула: средняя пропускная способность, число исключённых каналов и причинами.
7. Практический пример
Интернет-ретейлер, собирающий цены конкурентов, внедрил отказоустойчивый пул из 100 SOCKS5-каналов. Благодаря adaptive-ротации и backoff-стратегии среднее время получения ответа снизилось с 2,1 с до 1,2 с, а процент ошибок упал с 8 % до 1,5 %. Автоскейлинг агентов и географический резерв обеспечили непрерывность сбора данных при десятикратных пиковых нагрузках.